Si buscas un PC para IA con el que ejecutar modelos LLM y agentes en tu propia casa, lo primero que debes saber es que lo que manda no es el procesador, sino la memoria: cuánta tiene el equipo para cargar el modelo (VRAM o memoria unificada) y a qué velocidad la mueve. Un modelo de 8.000 millones de parámetros cabe en una tarjeta gráfica de 8 GB, pero uno de 70.000 millones necesita en torno a 40-48 GB, y ahí cambian por completo las opciones.
La otra pregunta es si de verdad necesitas IA local. Si usas agentes que tiran de modelos en la nube (asistentes de programación, automatizaciones por API), te basta un ordenador normal y bien equipado. En esta guía te explicamos qué ordenador necesitas en cada caso y recomendamos seis equipos y componentes. Hemos analizado especificaciones oficiales, opiniones verificadas y pruebas publicadas; no los hemos probado en persona.
- Apple Mac mini (M6 / M5 Pro): M6 para agentes en la nube; M5 Pro con 64 GB para modelos medianos en local.
- GMKtec EVO-X2 (Ryzen AI Max+ 395, 128 GB): mini PC con Windows o Linux para modelos grandes.
- NVIDIA DGX Spark: CUDA y 128 GB para desarrolladores.
- Apple Mac Studio (M5 Max / M5 Ultra): hasta 512 GB para modelos enormes.
- NVIDIA GeForce RTX 5060 Ti 16 GB: para empezar con IA local en tu PC de sobremesa.
- NVIDIA GeForce RTX 5090: máxima velocidad con modelos que caben en 32 GB.
| Modelo | Ideal para | Memoria para el modelo | Ancho de banda | Enlace |
|---|---|---|---|---|
| Apple Mac mini (M6 / M5 Pro) | Agentes en la nube y modelos pequeños o medianos | Hasta 32 GB (M6) o 64 GB (M5 Pro) unificada | 153-170 GB/s (M6) · 307 GB/s (M5 Pro) | Ver en Amazon → |
| GMKtec EVO-X2 (Ryzen AI Max+ 395, 128 GB) | Modelos grandes en Windows o Linux | 128 GB compartida | LPDDR5X-8000 de 256 bits | Ver en Amazon → |
| NVIDIA DGX Spark | Desarrollo con CUDA y ajuste fino | 128 GB unificada | 273 GB/s | Ver en Amazon → |
| Apple Mac Studio (M5 Max / M5 Ultra) | Modelos muy grandes y uso profesional | Hasta 128 GB (M5 Max) o 512 GB (M5 Ultra) | 460-614 GB/s · 1,2 TB/s | Ver en Amazon → |
| NVIDIA GeForce RTX 5060 Ti 16 GB | Empezar con IA local en un PC de sobremesa | 16 GB GDDR7 | 448 GB/s | Ver en Amazon → |
| NVIDIA GeForce RTX 5090 | Máxima velocidad con modelos de hasta unos 32.000 millones de parámetros | 32 GB GDDR7 | 1,79 TB/s | Ver en Amazon → |
¿Agentes en la nube o LLM en local? Lo primero que debes decidir
Un agente de IA encadena llamadas a un modelo de lenguaje con herramientas: leer archivos, ejecutar código o navegar. Dónde esté ese modelo lo decide todo:
- Modelo en la nube (por API o suscripción): el trabajo pesado lo hacen los servidores del proveedor. Te bastan 16 GB de RAM (32 GB si usas contenedores o varios proyectos), un SSD rápido y buena conexión.
- Modelo local (Ollama, LM Studio, llama.cpp): ganas privacidad, funciona sin conexión y no pagas por token, pero necesitas mucha memoria rápida. Además, los agentes consumen mucho contexto, y cada token de contexto ocupa memoria extra.
Muchos usuarios combinan ambos: los agentes complejos en la nube y un modelo local pequeño para tareas privadas. En ese caso no hace falta irse a la gama alta.
Cuánta memoria necesita cada modelo
La regla práctica que usa la comunidad con modelos cuantizados a 4 bits (el formato habitual en Ollama y LM Studio) es de unos 0,55-0,6 GB por cada mil millones de parámetros, más un margen para el contexto. Son estimaciones, pero sirven para orientarse:
- Modelos de 7-8B: unos 5-6 GB. Funcionan en una gráfica de 8 GB o en un Mac con 16 GB.
- Modelos de 13-14B: unos 9-11 GB. Lo cómodo es tener 12-16 GB de VRAM.
- Modelos de 32B: unos 20 GB. Necesitas 24-32 GB de VRAM o un equipo con 48-64 GB de memoria unificada.
- Modelos de 70B: entre 40 y 48 GB. Aquí entran los equipos de 64-128 GB de memoria unificada o varias gráficas.
- Modelos de más de 100B (incluidos muchos de tipo «mezcla de expertos»): 96 GB o más.
Si el modelo no cabe en la gráfica, parte pasa a la RAM del sistema y la velocidad cae en picado. Por eso una RTX 5090 vuela con un modelo de 32B, pero un equipo con 128 GB de memoria unificada le gana con uno de 70B.
Los mejores ordenadores y componentes para IA local en 2026
Apple Mac mini (M6 / M5 Pro)
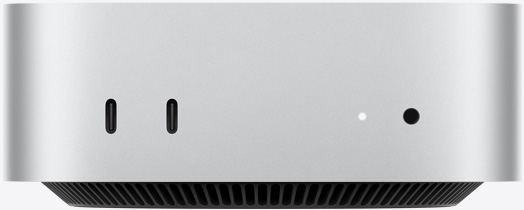
El Mac mini de 2026 tiene dos versiones. Según la ficha de Apple, la de chip M6 va de 16 a 32 GB de memoria unificada (153-170 GB/s), y la de M5 Pro, de 24 a 64 GB (307 GB/s).
Puntos fuertes: la GPU usa directamente la memoria unificada, así que los 64 GB del M5 Pro dan para modelos que no caben en ninguna gráfica de gama media. Es silencioso, gasta poco y LM Studio y Ollama funcionan de forma nativa. Para agentes en la nube, el M6 con 24-32 GB es un ordenador de trabajo excelente.
Puntos débiles: la memoria no se amplía, así que hay que acertar al comprar. Con modelos de 32B o más, su ancho de banda se nota: genera texto bastante más despacio que un Mac Studio.
Para quién es: quien quiere un equipo compacto para agentes y, a ratos, modelos de 8B a 32B en local. Para IA local, ve directamente al M5 Pro con 48 o 64 GB.
GMKtec EVO-X2 (Ryzen AI Max+ 395, 128 GB)
GMKtec EVO-X2 (Ryzen AI Max+ 395, 128 GB): el mini PC x86 con más memoria para modelos grandes sin necesidad de montar una torre.
Ver en Amazon →El EVO-X2 monta el AMD Ryzen AI Max+ 395 (16 núcleos Zen 5), gráfica integrada Radeon 8060S y 128 GB de LPDDR5X-8000 compartidos entre CPU y GPU (también hay versión de 64 GB). Incluye SSD de 2 TB, ranuras M.2 libres y USB4.
Puntos fuertes: es la forma más directa de tener memoria de nivel Mac Studio en un PC con Windows o Linux. Puedes reservar gran parte de los 128 GB para la gráfica y cargar modelos de 70B cuantizados o modelos de mezcla de expertos mayores, que en una gráfica de consumo no caben. Usa el mismo chip que el Framework Desktop, que Xataka destacó para experimentar con IA local.
Puntos débiles: la memoria va soldada. Su ancho de banda queda lejos de una RTX 5090, así que con modelos densos grandes genera texto a un ritmo correcto, pero no rápido. El software de IA de AMD (ROCm, Vulkan) sigue dando más guerra que CUDA en algunas herramientas.
Para quién es: quien quiere modelos grandes en local con Windows o Linux, prioriza memoria sobre velocidad punta y no quiere una torre. GMKtec ya ha anunciado el EVO-X5 Pro, con más memoria, pero es otro equipo y otra gama.
NVIDIA DGX Spark
NVIDIA DGX Spark: 128 GB de memoria unificada y todo el ecosistema CUDA en un equipo que cabe en la palma de la mano.
Ver en Amazon →El DGX Spark usa el superchip GB10 de NVIDIA: 20 núcleos Arm, GPU Blackwell y 128 GB de LPDDR5X unificada a 273 GB/s. NVIDIA anuncia inferencia con modelos de hasta 200.000 millones de parámetros y ajuste fino de hasta 70.000 millones. Además, con su red ConnectX-7 se pueden enlazar dos unidades.
Puntos fuertes: CUDA de serie: PyTorch, vLLM o el ajuste fino con LoRA funcionan sin pelearte con drivers. Para quien prepara agentes o modelos que luego irán a servidores NVIDIA, es lo más parecido a producción que cabe en una mesa.
Puntos débiles: con un ancho de banda similar al del EVO-X2, no genera texto más rápido que él. Funciona con DGX OS (basado en Ubuntu) sobre Arm, no es un PC de escritorio al uso, y es gama alta. Hay versiones de otros fabricantes con el mismo chip GB10.
Para quién es: desarrolladores e investigadores que necesitan CUDA y mucha memoria. Para solo chatear con modelos locales hay opciones más versátiles.
Apple Mac Studio (M5 Max / M5 Ultra)
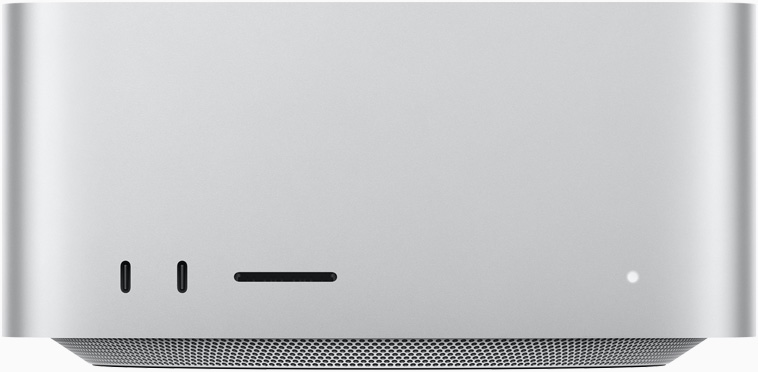
Apple renovó el Mac Studio en agosto de 2026. Según su ficha oficial, con M5 Max va de 36 a 128 GB de memoria unificada (460 GB/s, o 614 GB/s con GPU de 40 núcleos), y con M5 Ultra, de 96 a 512 GB a 1,2 TB/s.
Puntos fuertes: ningún sobremesa de consumo combina tanta memoria con tanto ancho de banda. Un M5 Max de 128 GB mueve modelos de 70B más rápido que el EVO-X2 o el DGX Spark, y un M5 Ultra con 256 o 512 GB carga modelos abiertos de cientos de miles de millones de parámetros. Silencioso y con un consumo contenido.
Puntos débiles: gama alta, y las configuraciones con mucha memoria se disparan. Sin CUDA, el ajuste fino va peor que en NVIDIA. La memoria no se amplía.
Para quién es: profesionales que quieren los modelos abiertos más grandes en local, o varios agentes con modelos de 30-70B a la vez, sin montar un servidor.
NVIDIA GeForce RTX 5060 Ti 16 GB
NVIDIA GeForce RTX 5060 Ti 16 GB: la tarjeta gráfica para IA más sensata para empezar si ya tienes un PC de sobremesa.
Ver en Amazon →Si ya tienes una torre, basta con cambiar la gráfica. La RTX 5060 Ti existe con 8 y 16 GB de GDDR7; para IA, solo tiene sentido la de 16 GB.
Puntos fuertes: carga modelos de 8B a 14B con contexto amplio, y CUDA garantiza compatibilidad con cualquier herramienta. Es la configuración que más se recomienda en los hilos de Reddit que encabezan Google para este tema. Consumo y tamaño razonables.
Puntos débiles: con modelos de 32B se queda corta y tendrá que descargar capas a la RAM, con la consiguiente pérdida de velocidad.
Para quién es: quien quiere probar IA local, autocompletado de código o un agente con un modelo pequeño gastando lo mínimo. Acompáñala de 32 GB de RAM.
NVIDIA GeForce RTX 5090
NVIDIA GeForce RTX 5090: la gráfica de consumo más rápida para LLM que caben en 32 GB.
Ver en Amazon →La RTX 5090 tiene 32 GB de GDDR7 y unos 1,8 TB/s de ancho de banda, el más alto de este artículo. La serie RTX 50 Super sigue sin anuncio oficial, así que la 5090 continúa siendo el techo de consumo.
Puntos fuertes: con modelos de hasta unos 32B cuantizados, nada de consumo genera texto tan rápido, algo que se agradece en agentes que hacen muchas llamadas seguidas. También brilla con generación de imagen y vídeo.
Puntos débiles: 32 GB no alcanzan para modelos de 70B sin recurrir a la RAM o a una segunda gráfica. Consume mucho, exige fuente potente y caja grande, y es gama alta.
Para quién es: usuarios con torre que trabajan con modelos de 14B a 32B y quieren máxima velocidad, o que combinan IA con creación de contenido o juegos.
Cómo elegir un PC para IA local
1. Empieza por el modelo, no por el ordenador
Decide qué tamaño de modelo quieres usar y calcula la memoria con la lista de arriba, dejando un 20-30 % de margen para el contexto, sobre todo con agentes.
2. Memoria de vídeo o unificada antes que RAM normal
La RAM de un PC convencional con gráfica dedicada sirve para el sistema, pero el modelo debe caber en la VRAM para ir rápido. En los Mac, en los Ryzen AI Max+ y en el DGX Spark, la memoria es compartida y la usa directamente la GPU: por eso 128 GB «valen» más ahí que 128 GB de DDR5 en una torre.
3. El ancho de banda decide la velocidad
Generar cada palabra obliga a leer el modelo entero de memoria, así que los tokens por segundo dependen sobre todo de los GB/s. Dos equipos con la misma memoria pueden ir uno al doble de rápido que el otro.
4. Ecosistema: CUDA, Apple o AMD
NVIDIA (CUDA) es lo más compatible, sobre todo para ajuste fino. Apple va muy bien para inferencia con LM Studio, Ollama y MLX. Con AMD, comprueba antes que tus herramientas lo admiten.
5. Ruido, consumo y formato
Si el equipo va a estar encendido todo el día atendiendo a un agente, un mini PC o un Mac consumen y hacen bastante menos ruido que una torre con una gráfica de 500 W.
Preguntas frecuentes
¿Cuánta RAM necesito para ejecutar un LLM en local?
16 GB para modelos de 7-8B, 16 GB de VRAM para 14B, 24-32 GB para 32B y 48-64 GB para 70B.
¿Es más importante la CPU o la GPU para IA local?
La GPU, y sobre todo su memoria. La CPU influye poco en la velocidad de generación cuando el modelo cabe en la gráfica. Solo cobra protagonismo si el modelo se desborda a la RAM del sistema, y aun así irá lento.
¿Necesito un ordenador potente para usar agentes de IA?
No, si los agentes usan modelos en la nube: con 16-32 GB de RAM y un buen SSD es suficiente. Solo necesitas un equipo potente si quieres que el modelo que mueve al agente se ejecute en tu ordenador.
¿Mac o PC para ejecutar modelos de IA en local?
Mac si quieres mucha memoria, silencio y facilidad de uso para inferencia. PC con NVIDIA si necesitas CUDA, ajuste fino o la máxima velocidad con modelos que caben en 16-32 GB. Los mini PC con Ryzen AI Max+ son un término medio con Windows o Linux.
¿Sirve la NPU de los «PC con IA» para ejecutar LLM?
Hoy, poco. Algunas herramientas empiezan a usarla para modelos pequeños, pero Ollama, LM Studio y llama.cpp trabajan sobre todo con la GPU. Fíjate en la memoria y en la gráfica, no en los TOPS de la NPU.
¿Puedo usar un portátil para IA local?
Sí, si tiene memoria suficiente: un MacBook Pro con mucha memoria unificada o un portátil con gráfica NVIDIA de 12-16 GB. Con cargas sostenidas se calentará y la batería durará poco.
Conclusión
El ordenador que necesitas depende de dónde viva el modelo. Para agentes en la nube, basta un Mac mini con M6 o cualquier PC con 16-32 GB de RAM. Para IA local, elige por memoria y ancho de banda: RTX 5060 Ti de 16 GB para empezar, RTX 5090 para máxima velocidad hasta 32B, y GMKtec EVO-X2, DGX Spark o Mac Studio para modelos de 70B o más.
Imagen de portada: Foto: cottonbro studio en Pexels